ALIGNWORLD
实验
01
2025一句话生成画面把一句描述交给视频模型,由模型直接画出每一帧。足够写实,但要靠抽卡,细节改不了。
「水壶往杯子里倒茶」
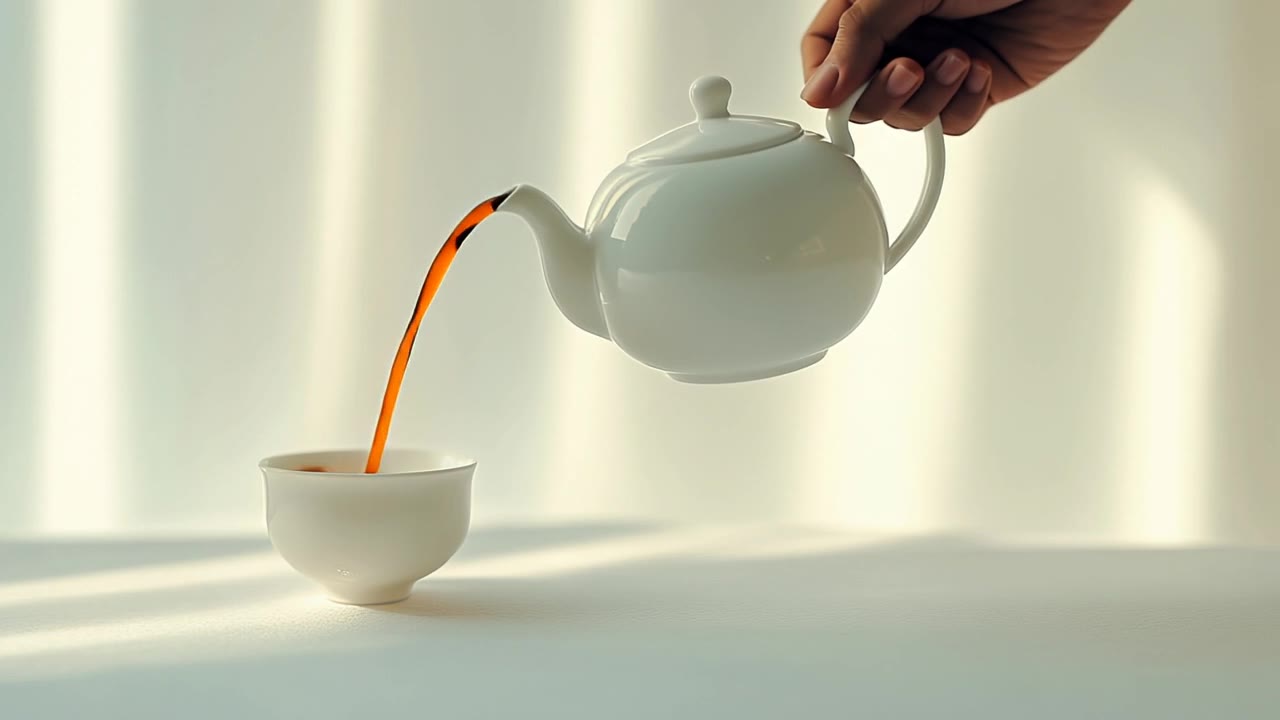
Runway Gen-45 秒
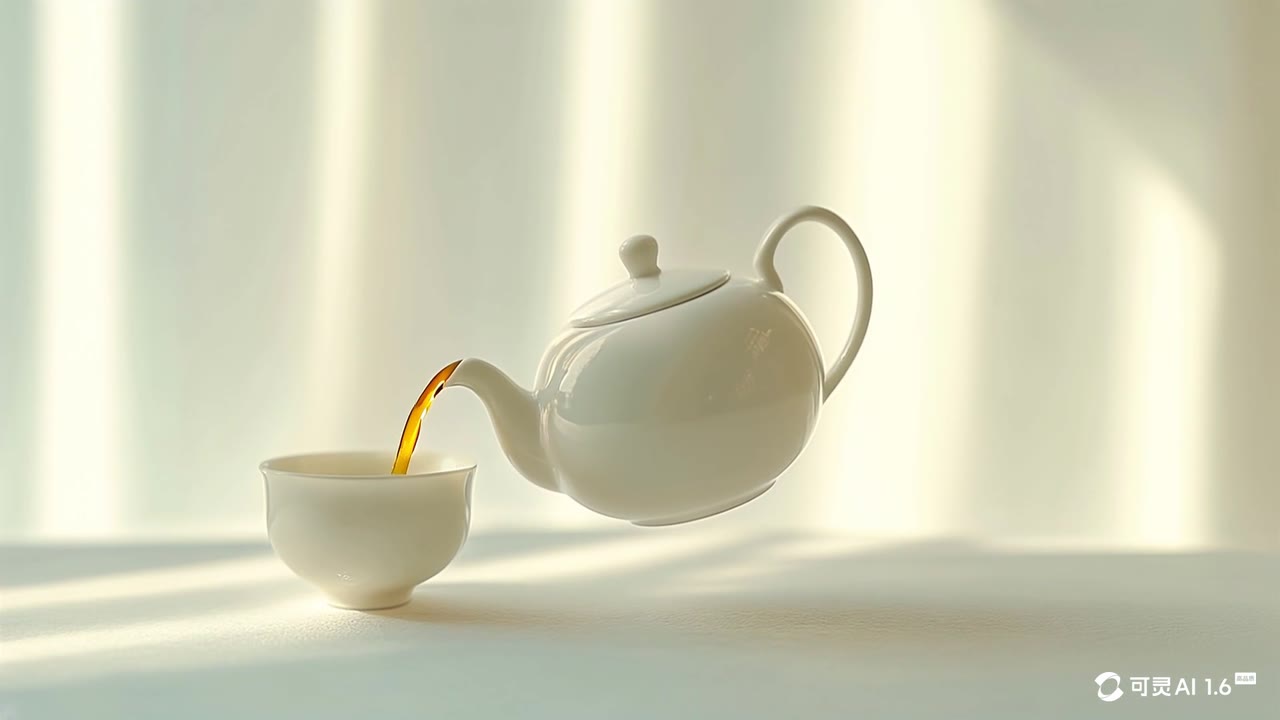
可灵 1.65.1 秒
画面都很像样,物理还不太懂:Gen-4 让一只手伸进来提壶,可灵 1.6 里的茶壶自己飘起来倒茶。
这不是同一种能力在变强,而是做法变了:从让模型直接画出每个像素,到让模型写出能生成画面的代码。
02
2026写代码做动效让 Claude 写 HTML / CSS / Shader,浏览器渲染后录屏。不追求写实,但每一帧都可控、可改、可重来。
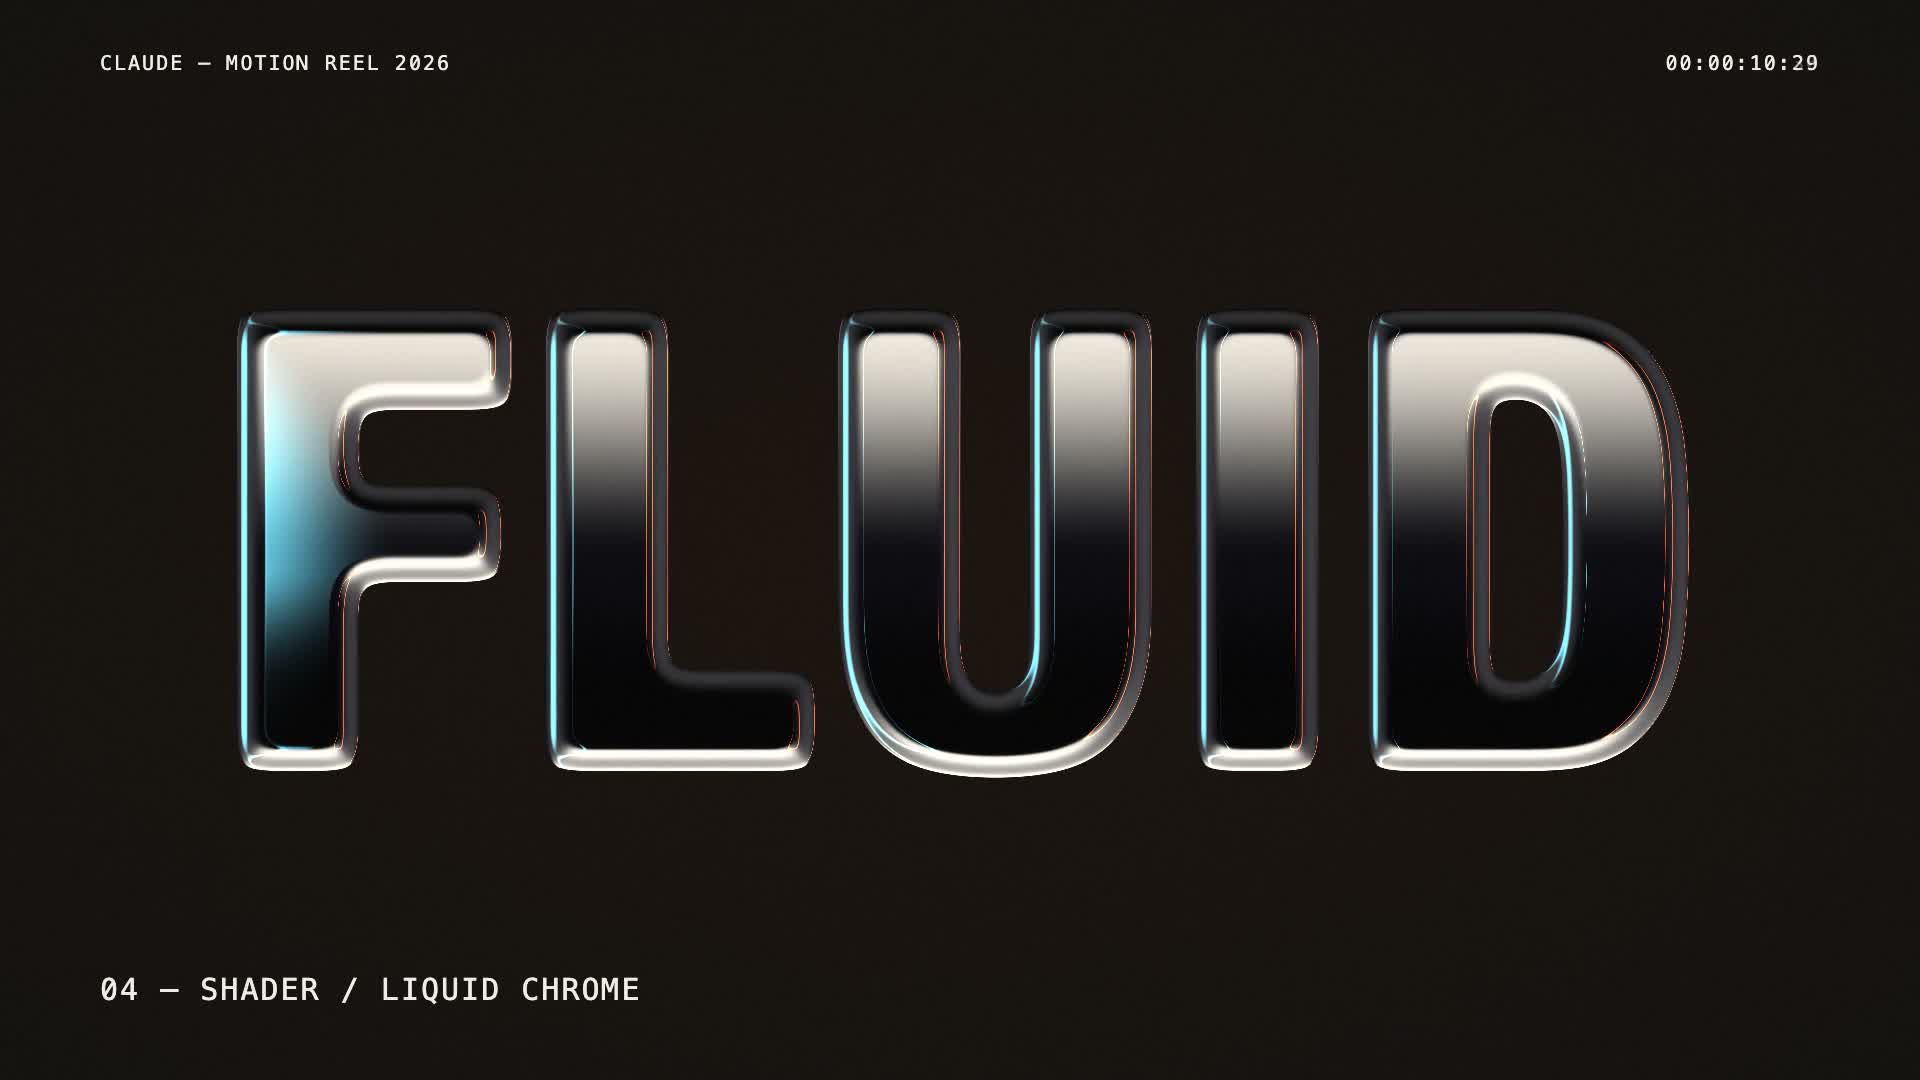
AI 动效短片
Claude Opus 5.5 · Steve · 15 秒
这也是下面这些知识演示的做法:同样是让模型写网页,只是从做动效,变成把一个概念拆开讲清楚。看知识演示 ↓
知识演示
用能播放、能逐步推进的小演示,把 AI 的原理拆开讲。这里先放三个,全部 9 个按主题分组放在演示目录里。